游戏生产AI落地武林秘籍·第二式「观局识阵」:图像掩码及语义抽象实现游戏场景理解
系列导读:「游戏生产AI落地武林秘籍」记录我来时路,都是血泪史。
我们在第一式「手到擒来」里教会了 AI 认识项目里的每一个资产——它知道shrub_jn_01a是哪棵江南矮灌木。但这还不够:认识每个兵卒,不等于看得懂整盘棋。 第二式「观局识阵」,要让 AI 看懂美术在地图上摆下的”阵”。注:每一篇文章几乎纯手工打造,请放心食用。如果你想直接看实现效果,不在乎实现方法,可以越过第三至第六章。
一、缘起:无法理解的场景
第一式我们通过语义编码认识了每个资产,这一回,我们要回答的是:我在哪里?
众所周知,LLM是不理解场景的,即使截图给它,它也看不懂美术摆下的龙门阵:
- “这个区域大概是什么风格?”
- AI:幻觉回答一下。
- “帮我去找场景中一个在楼梯边的宝箱”
- AI:遍历世界大纲里面的东西,然后一个个地去找。然后哪个在楼梯边?不知道。
- “给你一张图,这个图上的位置在我大世界的哪里啊?”
- AI:什么玩意儿?这我咋找?
- “帮我找到一个我用石头堆成的山洞”
- AI:@#¥%……&*
本文要解决的就是这些问题(地图理解因为内容有点多故分成两篇文章,此篇是第一篇,讲述理解地图,第二篇会讲全地图的向量检索)。
经过本轮修炼,你的 AI 能像人一样,真正意义上“理解”你的地图,并且将采集过的场景和位置“背”下来;对于未拍摄的视角,则计划通过相邻视角的插值推断加以补全,最终实现大世界地图任意位置的毫秒级查询。
二、如何理解一个场景?
我们来看一下,人类看到一个场景时,是怎么样的?
- 最先,是看到游戏场景 → “诶,黑黢黢的”(视觉)
- 然后,感受了其中的空间关系 → “咦,前面有点光”(空间)
- 最后,理解了场景所表达的含义 → “哦,这里那个白骨精的山洞”(语义)
他会怎么向别人表述这个场景,他说:
我刚刚去了一个场景,从 黑井附近 按E就可以进去,那个地方 比花果山山洞还要黑,我感觉那里应该就是 隐藏关卡boss白骨精的老窝 了。
根据上面的描述,我将理解和表述能力拆分开来:
| 感知 \ 表述 | 指代 | 比较 | 隐喻 |
|---|---|---|---|
| 视觉信息 | 🟢 用视觉风格指认 | 🟡 比较疏密与风格强度 | 🟠 借文化意象讲质感风格 |
| 空间信息 | 🟡 用空间位置指认对象 | 🟡 比较相对位置与分布 | 🟠 借他物形容空间形态 |
| 语义信息 | 🟡 用功能用途指认 | 🟠 表达偏好或否定 | 🔴 借他物讲功能与叙事 |
难度图例:🟢 易 | 🟡 中 | 🟠 难 | 🔴 极难(对 AI 来说既难以理解,又难以准确表达)
纵轴 · 感知层 对应 AI 理解场景的三类能力——
- 「视觉信息」——这片东西看起来怎么样?(风格、疏密、质感、美学印象)。
- 「空间信息」——A 和 B 在空间位置上,是怎么样的?(被谁包住、贴着谁、和谁相交、谁承载谁、谁遮挡谁——拓扑 + 方向 + 距离 + 承载 + 遮挡)。
其中拓扑关系(RCC-8:DC / EC / PO / EQ / TPP / NTPP…)是定性空间推理里相当成熟的研究领域,可参考 Cohn & Renz 的经典综述 Qualitative Spatial Representation and Reasoning。承载关系与遮挡关系在视觉感知研究里常被单列(如 Biederman 1982 的 Support / Interposition),但在引擎里它们落在同一套几何数据上,故本框架按数据源归并进空间。 - 「语义信息」——A 在场景里是干嘛用的、起什么叙事作用?
- 物件含义——这一个物品里面隐含着什么表达?
- 组合关系——组合在一起是什么意义(分体论 mereology,比如一堆石头中间掏个口子叫山洞)。
- 设计语义——这个场景很破败,是想表达一个正在经历饥荒的村庄。
- 共现关系——A 和 B 经常一起出现吗、什么搭配最稳?
这一层会同时碰到分布语义学、RDF(知识关系表示)和 FrameNet(框架语义)等不同方向。共现本身是从频次 / 向量里“学”出来的,不是从几何里“算”出来的;如果再进一步建模“当前状态如何影响下一个状态”,才进入 Markov(马尔可夫)模型的范围。我把共现作为语义的一部分,因为它表达的是比单体几何更高一层的场景逻辑。这个涉及到一定的表达,有点超纲本文内容。
横轴 · 表述层(能否把学到的转述出来) 对应本文关心的三种表达策略——
- 「指代」对应 deixis(指示语),靠共同注意锚定,不给坐标,也能指向同一个对象;
- 「比较」会用到 vague quantifier / vague language(模糊量词 / 模糊语言),不一定给出精确数字,而是给出方向、程度和隐含基线;
- 「隐喻」对应 conceptual metaphor(概念隐喻 / 跨域映射),借一种共享的文化经验来表达原本很难直接说清的空间、质感或功能。
一个理想的AI场景理解工具,理论上应该能做到上述 3 * 3 坐标里面所有的东西。
另外,一个优秀的agent,理论上还需要具备:长程场景记忆系统,即我们聊过的东西,再次提起还能查得到。
好,接下来我们来讨论实现。
三、别只聊MCP了,它注定是一个无底洞
其实,我们想要的是一个转译层,夹在引擎数据和大语言模型之间,把LLM想要了解的信息,从引擎中抽取,然后转译给LLM。那可能很自然地想到了MCP。
确实,MCP是过去一段时间很火的方案。
然而MCP这事并不是一个好活儿(不能快速地产出立竿见影的效果),它需要大量的资源投入及调优。
(事实上在过去一段时间里,我耗费了很多精力来调试,我甚至整理了一套调优方法论。每天盯着埋点数据,老实说,效果仍然称不上满意)。

为什么?
如果用过一些 UE 的 MCP 工具,就会发现,当前游戏引擎的场景理解部分存在许多问题:
它并不能真正理解我要的场景风格:
人是有抽象能力的,即我看到一片草地,我能说出这片草地的疏密;它不能“理解”,也不能“总结”。上下文爆炸,工具数量几何倍数增长:
现在很多 MCP 的实际做法是将给 UI 的接口开放给 LLM,这件事情就像是给一个剑客发了一把菜刀,能用,但很别扭。UI 是给人用的,从架构层面上一开始就没有考虑到上下文容量、幻觉等 AI 弱势项。更多任务,就意味着更多接口:
原子工具的签名是死的,比如find这个功能,一开始只用来按名字查资产;可任务很快变成“找一个在楼梯边的宝箱”(要邻近关系判断)、“找这种风格的灌木”(要语义过滤)、“数一下这片区域有多少块石头”(要聚合统计)。同一个find,背后其实是几种完全不同的运算。一个写死的接口扛不住这种跨度,硬扛就是要么工具数量爆炸,要么分析深度不够。而且,根据我这段时间的测试,我发现提供越多 MCP 接口,反而会得到更差的完成率——问题不在工具能力不足,而是模型根本不知道选择什么工具。没有校验,错一步后面全错:
Agent 每调一次工具都可能出错,绝大多数 MCP只管”给数据”,不管”对不对”。它说”xxx有棵松树”,你信不信?没有一面让它照自己的镜子,错误就在多步推理里越滚越大,最后跑偏了你都不知道是哪一步开始歪的。又慢又贵,不如自己干:
单次探查要过桥、要等编辑器、要烧 token,等它转完一圈,我自己点几下都弄完了。账面能力再全,单次的时间和费用打不过”人直上手”,那它在严肃工程里就立不住脚。
其实,除了MCP,我们手边还有很多可以利用的方案:
| 方案 | 原理一句话 | 单次响应时间 | 上下文 | 读写 | AI 兼容 | 跨版本 | 单次算力 | 致命坑 |
|---|---|---|---|---|---|---|---|---|
| MCP | 引擎开 MCP server(JSON-RPC) | 🟡 s | 🔴 接口全开 | ✅ | 🟢 协议原生 | 🔴 绑 API | 🟡 | 慢 + 贵 + 上文炸 + 粒度错位 |
| CLI + Commandlet | 启动 headless UE 跑命令 | 🔴 30s+(每次付) | 🟢 落盘 | ✅ | 🟡 要二次解析 | 🟡 绑版本 | 🔴 fork | 冷启动慢 = 不可交互 |
| 导出快照文本 | 引擎 cook → JSON/XML 落盘 | 🟡 s | 🔴 大场景炸 | 🔴 偏读 | 🟡 伪友好 | 🟡 格式脆 | 🟡 | 时差 + 单向 + 格式脆 |
| OpenUSD | 标准化场景描述,双端读写 | 🟢 s | 🟡 结构化 | ✅ | 🟢 文本母语 | 🟢 标准稳 | 🟢 | 游戏行业未统一 |
| 直读截图 | 渲染 + VLM 看图 | 🔴 十 s+ | 🔴 图像 token | 🔴 偏观察 | 🟢 多模态原生 | 🟢 灵活 | 🔴 极高 | 贵 + 受视角和渲染状态影响 + 失结构 |
上面这五种方案,按”信息从哪来”可以归成三类:
- MCP + CLI:通过引擎接口在线获取信息。好处是数据新鲜度最高、能实时反映当前场景状态;代价是接口要自己维护、返回数据量大,还要吃引擎版本迭代的成本。
- 导出快照 + OpenUSD:以离线数据还原场景信息。好处是不占引擎运行时、可版本化、便于跨工具读写;代价是有时差、且大场景下快照体积容易爆炸。
- 直读截图:通过图像 + VLM获取信息,更接近人观察场景的方式。好处是语义直觉强、跨版本灵活;坏处是上限完全取决于 VLM 对图像的理解力和图像本身的信息量。
小孩子才做选择,我全都要!我将上面的方案,两两结合。
针对视觉、空间与语义(上文 3 * 3 坐标纵轴坐标),我分别提出了三个应对的方法及技术实现:
- 视觉信息 ➡️ 2D资产掩码方案 (VLM截图 + 导出快照文本,扩展图片的理解力)
- 空间信息 ➡️ GSDL 通用场景描述语言 (颗粒度可变的人类语言级USD + MCP,解决上下文爆炸问题及场景空间感知弱项)
- 语义信息 ➡️ Vector Atlas 全地图语义编码(Commandlet + 上面二者结合后的全地图扩展,在实现上遇到的卡点太多,值得我单独开一篇文章更详细地来聊)
下面展开介绍。
四、2D资产掩码方案
1. 视觉理解为什么只看截图不够
首先来讲视觉信息的语义理解,理论上来说,直接将图片拿给VLM或是图像理解能力扩展后的LLM,是最直接,最接近人类感知的方案。
理想情况下,如果大模型可以直接读懂视频,并看懂空间关系后,执行对应的操作,这听起来像世界模型干的事情。但目前LLM似乎还不是很能达到类似的效果。
所以我看到一些产品会额外导出深度图、法线图等辅助通道,给 VLM 补足空间感知能力,但这通常仰赖模型的训练数据,抛开图片本身的巨量token消耗不谈,一旦当画面变得很模糊,或者画面中的actor带有的风格化显示,和训练数据不一致的时候,就会产生理解的漂移。
所以在我看来直接喂图的方案并不是一个很优的解决方案。
但”看不懂”的根源在哪?
我们可以回到计算机视觉的课程
——理解画面,本质上是理解像素拼出的图像所代表的物体的含义:把像素还原成”这里是什么、那里是什么”的结构化语义信息。
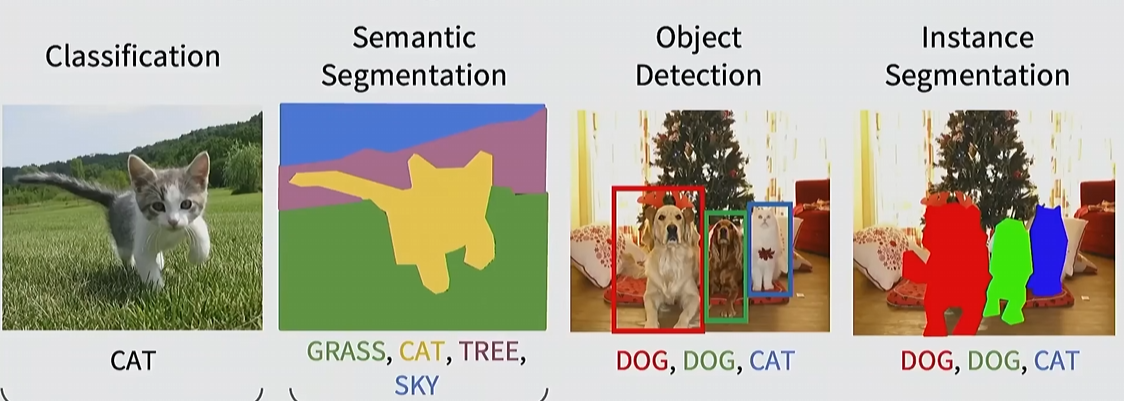
在图像理解领域,常见的基础任务包括图像分类、目标检测、语义分割和实例分割。
中台的同事 Fufu 在七月初提出来的一个图像识别-射线检测的方案:先通过小模型区分出场景中的 actor(物体识别),然后再通过射线检测,去 get 到这个 actor(实例分割)。这个方案通过视觉分析的小模型的中间层,实现LLM主动地去获取画面中的内容。对画面内容进行分割、解析,以达到对画面的理解的能力。
(BTW:在大模型和应用之间叠中间层,这是 agent 设计中一个很棒的 trick,我后面提到的 GSDL 也是基于这个逻辑)
这个方案启发了我。
可是,这又回到了那个问题,如果只是让模型去直接区分图像,会有一定的失败概率,就又会造成分析的不稳定性这个问题的出现。
于是,为何不反着来?引擎主动提供每个位置上的点分别代表什么actor,然后输出一张掩码表给LLM,以此补足LLM无法完整地区分画面的每个组成部分的问题。
这就是我的“2D 资产掩码方案”——LLM提出要在某个位置拍摄图像,编辑器响应,在拍图图像时,(可选)不只是拍摄图像信息,而是一次性给出整个画面的所有内容,将图片信息压缩成文字,并标注画面中每个部分代表的是什么。(该方案不仅token 消耗猛猛降,同时又达到超高物体识别率,稳定性极高的实例分割 Instance Segmentation方案)
2. 如何建立视觉归属
实际上,引擎编辑器为了支持物体点选,会维护一套 Hit Proxy(点选代理)的渲染与读取机制。其缓冲区与视口对应,可命中的像素会关联一个 Hit Proxy,进而还原到 Actor、Component 或其他编辑器对象。我们可以复用这套数据,将像素归属主动提供给 LLM;相比额外运行视觉分割模型,它的获取和解析成本很低。
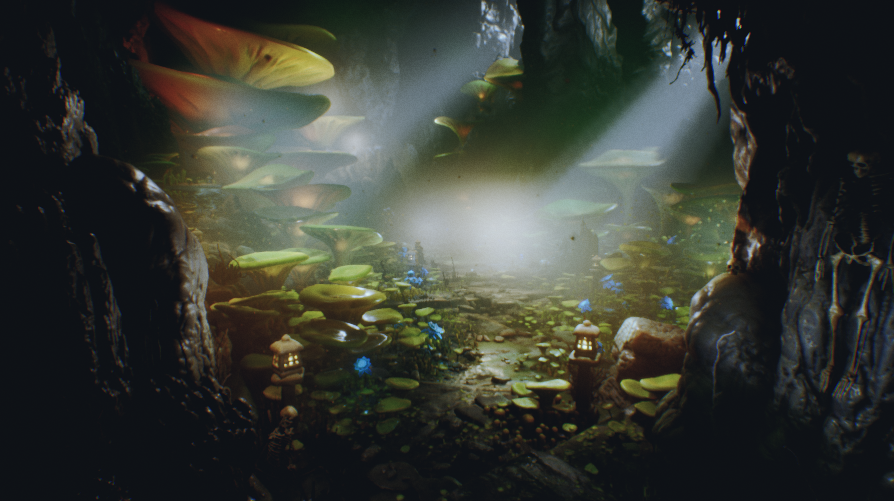
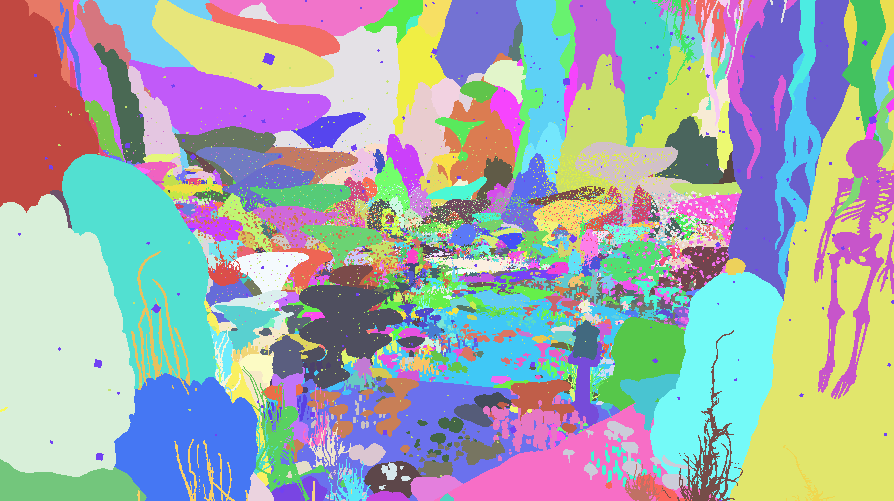
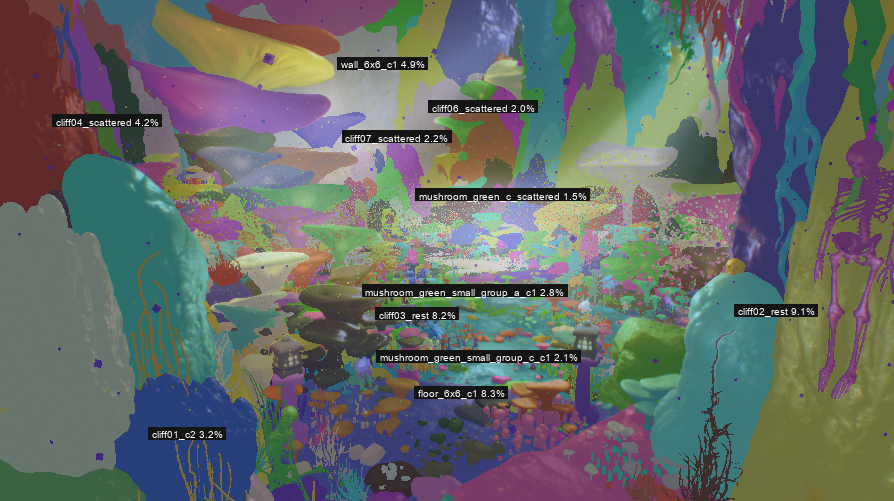
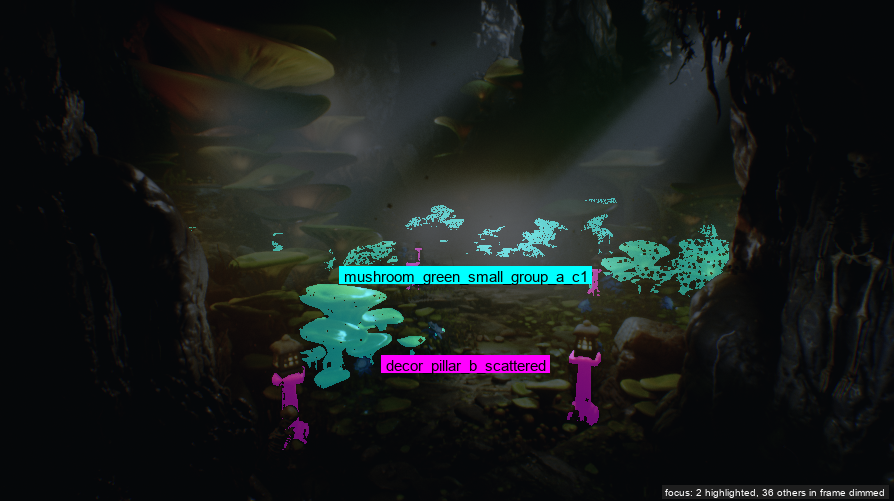
拿到了画面中的每一个actor后,就可以知道画面的语义了吗?
是的!当然可以。
因为好巧不巧,我前段时间刚好做了一个资产理解工具(上一期)


在做资产理解的时候,我就做了一件事情,我为每个资产都生成了描述(左图,而且这些描述还在被美术不断地更新,优化)。
资产掩码信息统计下来(右图),能够知道:
- 这个资产在画面中的占比、分布、距离;
- 它的原始资产是什么(能链接到资产语义);
- 它在场景中叫什么名字,在场景中的参数。
等信息。
3. 边缘情况及视觉模型本地支持
细心的读者可能已经注意到——hit proxy 报回来的对象里,会有三类”特殊资产”要走专属通道,我对他们进行了专门处理:
- 程序化植被(拆开来,按照foliage的actor归属对应的资产语义);
- 地形(hit proxy 报回来的是一整座 Landscape proxy(一块名字、一大片像素),可美术其实在 weightmap 里刷了 N 个用户层(草 / 沙 / 雪 / 水……)。这时接合层要走一条专路:世界坐标 → proxy 局部 UV(按 proxy 的 scale 算)→ weightmap 纹理采样 → ULandscapeLayerInfoObject::GetLayerName()——整条链路不会有任何视觉推断,稳定性会极高)
- 天空/大气等引擎内置对象(因为数量比较少,手写语义,不依赖 hit proxy)。
现在,我们把这些描述 + 画面 + 掩码信息(按不同 LoD 组织)拿给 VLM,让它为这个画面生成一个描述(套娃了属实是),就可以得到最基本的单次截图信息。这些 LoD 可以做成接口参数,以适配不同颗粒度的使用场景。
这里的 LoD 描述的是“给模型看的信息颗粒度”,不是 Mesh 的几何精度,但编号方向保持一致。
想要更进一步,我们甚至可以在 MCP 中本地部署一个小的视觉语言模型(譬如 Qwen2.5-VL-7B int4 VRAM平均占用5.95GB,峰值6.65GB,可以在大部分的美术本地跑起来。或者团队局域网部署qwen3.8 27b,也不是很难的事情)。
图片及信息解释是典型的感知任务(perception),不存在较长的逻辑链路——这正是小模型的甜区。现在的 VLM 普遍经过大规模图像或图文数据预训练,已经具备了基础的视觉语义能力。这样套一个本地部署中间层,可以让Deepseek v4 flash 0731这样便宜又好用的非多模态模型也能支持我们的视觉理解;
至于小模型能做什么、不能做什么,大致可以这样划分:
| 维度 | 🟢 小模型够用的情况 | 🔴 小模型开始吃力的情况 |
|---|---|---|
| 空间 | “画面里有宝箱 / 蘑菇 / 石块 / 远处剪影” | “宝箱和最近蘑菇的精确距离、3D 坐标反投影” |
| 视觉 | “暖色调、洞穴氛围、低多边形风格” | “这张图和概念图在剪影上的偏差 0.7 / 哪个主语破坏了构图” |
| 语义 | “有什么”(感知) | “为什么这样摆、应该怎么改”(推理 + 决策) |
但这个部署问题就取决于不同环境的具体情况。
(8.10日补:阿里前几天发布了Qwen-MM-Plugins和我的想法很像,将视觉理解这个事情放到Harness层面,通过多层分辨率设计与抽帧方案实现图片和视频的理解,基本上完成了我这个sidecar视觉辅助能力。我在后面也会升级我的方案)
所以基于我的这个框架,画面里的所有东西都能有语义归属。至于 PPV / 灯光等压根不被命中的辅助对象,图像掩码里自然不会留下它们的痕迹,那么就需要另一种probe的维度(有请GSDL)。
五、GSDL(通用场景描述语言)
没听过这个东西是吧。
我自己造的。🐶
1. 如何理解空间?
2D 掩码方案实际上只补上了一半内容——它让模型知道了“画面里有什么”(视觉信息 + 内容语义),而文首那张场景理解能力表格里的“空间关系”依旧是没做的。
引擎编辑器是为人打造的,对于人而言,只要扫一眼视口,就能感觉到这片区域密不密、东西是散开的还是抱团的;引擎编辑器是不能直接回答这些问题的。
我们要的这些数据,并不是引擎某个字段里藏着、可以直接伸手去拿的数据。它要从 Actor、坐标、包围盒、碰撞、地形、射线和渲染结果里重新测量、统计和推导出来,但引擎并没有提供类似的现成接口。这些信息对于人来说,逛一遍场景就能感性地获得,但是对LLM来说不是。
我的 GSDL 干的就是这件事:通过一些测量的手段,把引擎提供的底层状态,烹饪、压缩成 AI 可以查询、比较和复核的场景事实(scene facts,比如A处有一片高山,B处有一个洼地)。
实现上,它也基于MCP,但并不是直接拿引擎的裸接口——中间隔着一层GSDL查询函数作为中转(这层查询函数,就是GSDL最重要的规则和约定)。每次查询都由这层函数先在场景里完成测量,再把结果转换成标准化的语言返还给大语言模型。所以某种意义上,它也可以被看作一种OpenUSD式的文本描述语言。
不过,“描述语言”只是它最终的产出形态。更准确地说,GSDL 是一整套面向 AI 的场景观测、测量与描述方法论:一头衔接着引擎里的几何和渲染事实,一头衔接着资产语义,再把“这里有什么、怎么分布、彼此是什么关系”整理成多档 LoD 的结构化语言描述,交给 LLM。
这张图就是一次完整查询的环路。MCP 在这里只是一层薄封装——它自己不干活,只负责把调用转进引擎:
① 模型发起 MCP 调用(describe_region、find_opening、compare…),先落进 ② 的“MCP 查询接口”——也就是上一段说的那层 GSDL 查询函数;
② 请求经文件桥接进入 UE,由场景探针真正完成测量,吐出的是尚未压缩的原始事实;
③ 空间内核把这些事实聚类、推导出关系,GSDL 编码器再按 LoD 和字符预算把它们压缩成标准化语言,模型这才读到结果;
读完之后,模型思考、决定下一轮该测什么,再带着新的疑问回到 ①——查询就这样一圈圈转下去。
综上,它主要负责两件事情:
- 理解空间信息(把离散对象组织成密度、结构、关系、可见性和语义归属)
- 获取的信息压缩(把获取的信息通过一定的规则压缩成规则严谨的语义表述)
下面我分别介绍。
2. 空间是如何被测量的?
我拿其中一个接口做图形化的展示,让你更加明白地了解它的实现逻辑。
下面这个接口叫作find_opening。它主要测试当前的腔体环境中是否存在开口。
比如说在一个山洞中,通过这种算法能测出环境中存在几个洞口、房间有没有开着的窗户之类的应用场景。
其实UE本身是一个很棒的仿真工具,在里面其实可以做很多“测量”的工作。
游戏引擎本身就有射线检测接口——UE 里叫 LineTraceSingleByChannel,是物理引擎原生开放给上层做碰撞查询的能力。墙、岩石和门框都是正空间,洞口恰恰是它们围出来的负空间。
因此find_opening的查询方法,不是通过搜索名字中带 Door 或 Archway 的 Actor,而是反过来使用碰撞查询:命中的射线勾勒洞壁,能够连续逃逸到远处的射线组成开口,再回到开口两侧寻找真实门框。
实现大致可以拆成五步:
- 找内部点。 在腔体内铺一批采样点,挑出真正处于洞内的。
- 选观察位。 从中取几个互相错开的点,作为观察位置。
- 打射线。 从各观察位向四周发射线,找通向远处的方向。
- 汇总分类。 合并各处观察,区分洞口、高窗与内部通道。
- 量具体尺寸。 回到洞口边缘细测,给出实际宽高。
底层的 C++ Probe 负责从 Editor 现场取得地形、实例、碰撞命中和射线结果;Python 空间内核负责候选采样、测站选择、扇区融合、类型判断与精测调度。然后将经过测算的结果结论给到LLM,模型拿到的不再是一万多条原始射线,而是一组带有类型、位置、方向、宽高、来源测站和证据等级的场景事实。模型既能直接引用测量值,也能沿工具给出的机位再去截图复核。
于是我们便完成了对场景的空间关系的理解。
3. 语言是如何被压缩的?
上一节的五步测量走完,手里攥着的是一万多条射线、几百个采样点、三千多个实例的原始事实。这些东西没法直接交给模型——上下文会当场爆炸。(所以我在上面的Canvas图表中有一个python数据整理层,来压缩数据信息再给LLM,下面讲的就是在这个python压缩层)
压缩不是把句子改短,它是语言层的一套设计原则:
- 描述不等于倒数据。 工具把原始实例数据烹饪成陈述——
“*此区域 3242 个实例、200 种资产、聚成 12 簇,最大簇在东南...*”(类似于这样的描述)。给模型看的文本超了预算的话,就自动退到更粗一级的 LoD,信息本身仍保留在更细的层级里。 - 分层披露,先给摘要。 描述分 LoD0–LoD3 四档:LoD3 是一段话摘要,LoD2 是资产清单与统计,LoD1 展开簇和空间关系,LoD0 保留逐实例明细;另有 channels 按主题切块。模型默认只拿 LoD3 摘要:先花小 token 判断值不值得深看,值得再逐层下钻——和人逛场景一个道理,先扫全景,有兴趣才走近。
- 聚合是可逆的。 压缩掉的信息不是丢了:LoD1 里看到的是簇,要哪个簇的 LoD0 逐实例精度,
expand只钻那一个,不必重描整片。 - 截断必须自曝。 凡是压过的地方都带记号:
truncated (~30% sampled)、(3 of 148)、宽度带~——模型读到的每个数字都知道自己是全量还是样本。
这就是第一节说的“把获取的信息压缩成规则严谨的语义表述”:压缩的是 token,通过渐进披露保留信息。
举个例子。同一个区域执行 describe_region,四档输出的token消耗:
| 输出形态 | 模型读到什么 | 字符 | ≈ token |
|---|---|---|---|
| 裸 JSON(倒数据) | 每个实例一行坐标数组 | 461,193 | ~115,000 |
| LoD3 摘要 | 一句话 | 244 | 61 |
| LoD2 清单 | 物种清单 + 密度统计 | 840 | 210 |
| LoD1 关系 | 簇 + 空间关系 + 统计 | 2,616 | 654 |
| LoD0 明细(expand 单簇) | 只钻一个类别,散石簇 20 实例 | 1,687 | 421 |
| LoD0 明细(整区域) | 逐实例明细,约 23 token/个,不存在一次性拿整个区域的情况。 如果强制全量输出甚至会比原始Json更多,因为我们有很多标注符。 | 921,223 | ~230,000 |
LoD3 全文原样贴出来:
1 | @gsdl v0.1 |
LoD3 这段全文,逐行每句话在说什么:
@gsdl v0.1——版本声明;@project: ScatterTest——所在地图;@asset_classes: [Foliage, StaticMesh]——区域里出现的资产大类;@enrichment: []——语义增强槽,接的是第一式的资产语义编码,这片区域没用到;@frame: m——单位约定:往后所有长度一律米、角度一律罗盘度,模型不用猜 92.05 是厘米还是米;region(id=R7, bbox=[0.0..200.0, 0.0..200.0, 0.0..18.0]m)——区域外壳:花括号里的每条陈述,管辖范围就是这个包围盒,一寸不多一寸不少;# -- summary (LoD3) --——通道块标题,标记下面属于哪个主题块;R7 summary “锚=watch_tower; 10021实例/3类; 密度0.25/m²; 朝向散.”.——唯一的正文,也是全文唯一的句式:三元组。主语 R7、谓词 summary、宾语是这句分号串联的压缩陈述,行尾句号收束;谓词都来自一张固定词汇表(located_at、bound、near、density……),没有自由发挥的散文。
谓语里面:锚=watch_tower——锚是这片区域的地标,由显著度(视觉面积×稀有度)选出,一万棵六米高的松树里,就那座 18 米的瞭望塔配得上;此后簇与簇的空间关系都挂在它身上(pine_c2 of watch_tower、pine_c2 offset (dir=NE, d=43.2m) 就是以它为原点的相对表述)。10021实例/3类 是量级,密度0.25/m² 是疏密,朝向散 是朝向熵的档位(摆放的是乱还是规整)。
人指路也是这个顺序——先报地标(“黑井附近”),再给相对关系(“比花果山山洞还黑”);锚,就是把人类这个习惯写成了语法。
这段里示例还有两个语法元素你看不到。
一个是精度描述:
- 实测值不带符号(
pine_c1.1 pose [92.05, 12.65, 0.0]m,每个数都是量出来的); - 估计值带
~(watch_tower salience ~1.00,显著度是算出来的估计); - 分类判定带
#(size_dist {M:20, L:10001}#,分桶是规则判的,不是量的)。
另一个是指代方案:
会把相似的东西整合成一个“簇”,碎尾合并成弥散场,再多的实例,最后会整合成十来个名字(即十几种元素)。比如一盒铅笔,我们没必要说,铅笔A、铅笔B…这也是指代上的一种压缩技巧。
总之,锚点、量级、密度、朝向都在这 61 个 token 里——模型会根据自己在意的点往下深究。
LoD0 是一个实例一到两行,长这样:
1 | pine_c1.1 pose [92.05, 12.65, 0.0]m @ yaw=99.7°. |
模型可以自己调用,去获取自己在意的信息。
聊到这里,你还记得我在 “二、如何理解一个场景” 这一段里,提及的理解/表述 的那个 3* 3的表格吗?我提及表述层有我总结的三种表达策略:「指代」「比较」「隐喻」,现在可以验收了:
「指代」——锚和簇干的就是这个:模型说 pine_c2、说“瞭望塔东北那团”,指的是同一个东西;offset (dir=NE, d=43.2m) 就是“黑井附近”的正式写法。
「比较」——在 GSDL 里是档位化的,既可以给出精确的数值,也要能给出对比档位。但是档位就涉及到量化、判断,而一旦出现判断就会不稳定。所以我在 3* 3的表格里给了比较一个🟠(难)。
第三种「隐喻」(比如:这个洞像白骨精的老窝)确实很难,一方面要靠LLM的自我理解能力,另一方面靠文章后面提到的Vector Atlas(全地图语义编码),需要美术去教和标注。
4. 自进化的接口
上面提到的接口只是一个例子。GSDL 当前能测量的空间能力大致长这样(2026 年 7 月 20 日左右的版本):
| 能力 | 代表接口 | 核心实现 | 能回答的问题 |
|---|---|---|---|
| 拓扑 | compare(on="spatial")、query |
world-AABB 判定(RCC-8),容差随尺度自适应,输出 DC / EC / PO / TPP 等关系码 | 隔着、贴着、相交,还是谁包着谁? |
| 方向 | compare(on="spatial")、describe_region |
罗盘八向;朝向判定:相向 / 并排 / 对置 / 斜交 | A 在 B 哪边?相向还是背对? |
| 距离 | compare(on="spatial")、query |
AABB 表面间隙、中心距、垂直偏移;near 按脚印阈值分级 |
隔多远?谁高谁低?算不算“挨着”? |
| 承载 | describe_region、relation_trace、compare |
垂直接触 + 脚印重叠的支撑证据,稀疏支撑图 | 谁承载谁?“杯子放在桌上”是量出来的 |
| 通行遮挡 | find_opening、skyline、query_view、rays / los_ring |
多测站射线、逃逸方向聚类、门框重测;遮挡相对机位,射线与掩码共判 | 洞穴几个出口?视线被什么挡住? |
表格里面的功能对应着我们上文提到的空间关系。
然后还会包含一些辅助空间功能——
| 能力 | 代表接口 | 核心实现 | 能回答的问题 |
|---|---|---|---|
| 普查 | scan_density、describe_region |
枚举 Actor / Instance / Landscape,网格聚合,生成快照、簇与分层摘要 | 这里有什么?集中在哪?散布还是聚集? |
| 定位 | search_subjects、find_by_class、actor_meta、semantic_search |
名称与中文别名索引、类查询、资产元数据联接、检索结果与实例交叉验证 | “宝箱”叫什么?在哪?用什么资产? |
先知道这里有什么、说的是哪个实例,才谈得上空间关系。LLM才会调用具体的理解接口去做事情。
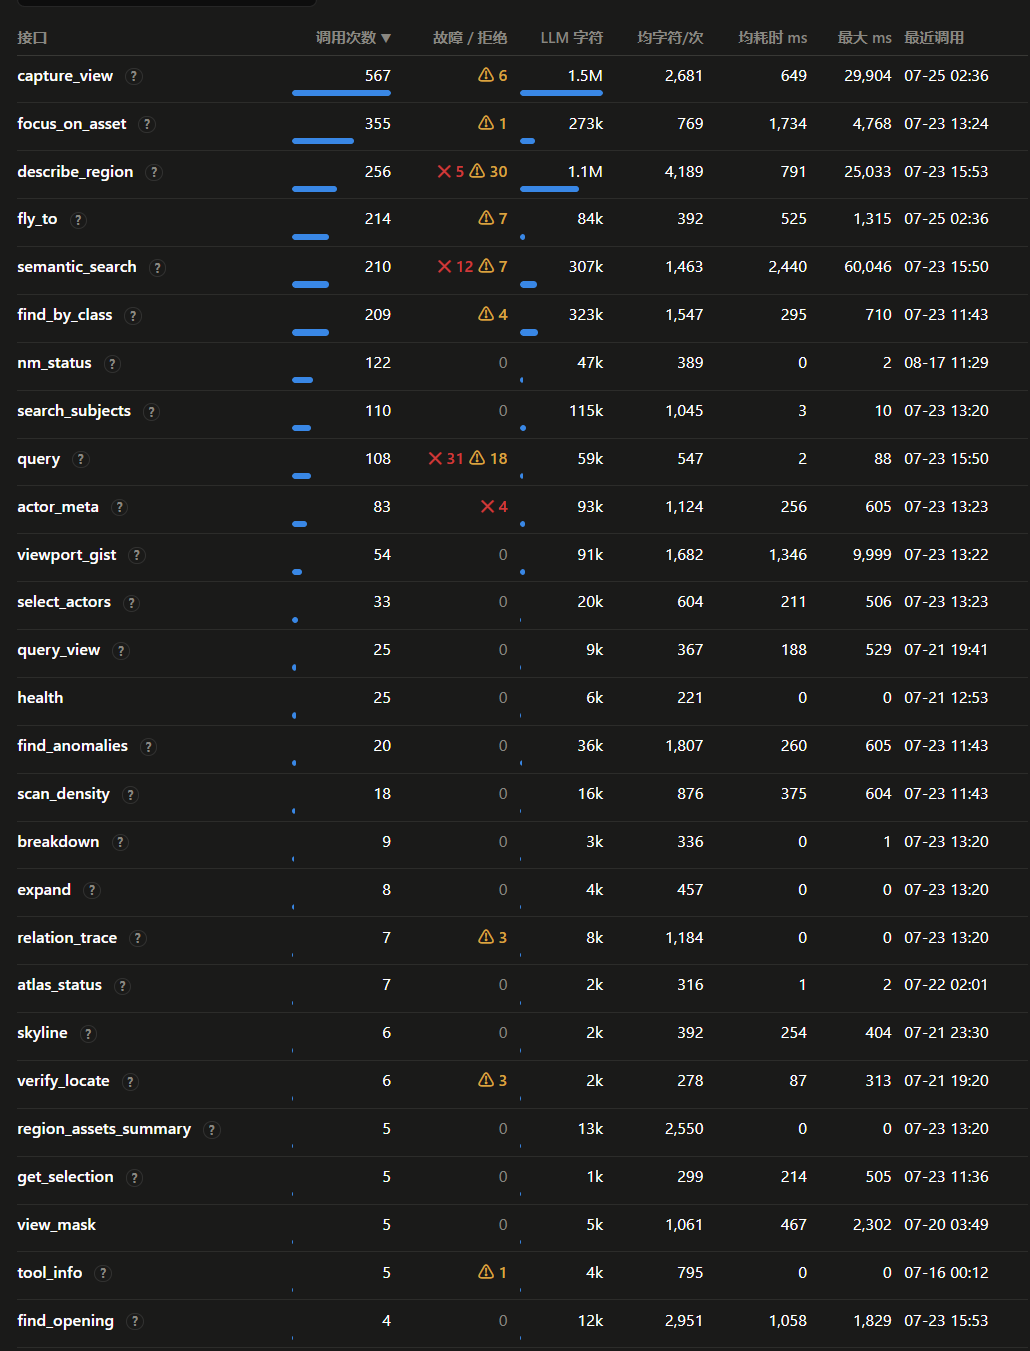
GSDL 对外提供的是一组面向问题、且仍在生长的测量能力。这份清单不是一次性设计出来的,而是被每一轮评测数据推着长出来的,所以上面给你看到的只是它某一个时间切片的样子。
(目前大概有 35 个接口,其中大概20个左右是目前稳定的)
我之前也试过用常规的方式来对它进行迭代。但是效果微乎其微(问题主要是:迭代速度太慢,另外我的个人判断也过于主观),后面我改成了“基于 /Loop 的评测驱动”的方式来优化接口:先建好一批场景测试题,LLM 直接基于每轮的执行数据和结果自己判断自我迭代,效果有了质的飞跃。
我的 /Loop 循环开发大致分为两个阶段:
第一个阶段,我给它写了36道测试题(因为测试题不够,最早是11道题,后来扩展为36道,全是手动提问并人肉标注答案,累死俺了)。
这些测试题涵盖了:
- 描述与理解(当前视口里有什么、一片城区是怎么规划的、功能怎么分区)
- 空间关系:(A 离 B 多远、在哪个方向、谁比谁高、谁挡着谁)
- 异常检测:(有没有悬空、穿模、明显摆错位的东西)
- 通行结构(这个洞穴有几个洞口、分别多宽)
- 复合体拆解(14 个牌坊资产里哪 6 个组成完整牌坊、一座瓮城由哪些构件构成)
- 诚实否认(场景里没有汽车、没有霓虹灯,能否有依据地说“没有”,而不是硬猜一个)等等十几个方向的内容。
所有题目都用自然语言出题、并且刻意不点名任何工具名。
我使用两个agent都跑/Loop循环,一个跑测试(开N个空白上下文的子agent去调用mcp进行提问,Fable5主agent只负责调度,写总结文档,和提需求),一个改代码(opus/GLM5.2 根据前者的需求优化接口逻辑)。
(跑mcp测试的子 agent 用本地 qwen3.6 27b、minimax m3。SOTA 模型的完成率确实更高,但真实场景里一旦大量铺开,MCP 消耗会是个可怕的数字——工具是面向生产的,不是用来跑分的,那就得按生产环境里真正会用的模型来适配)
我主要看三个主要硬性指标:
- 交付能力(完成率、正确率、诚实度) ;
- 成本(真实Token消耗、接口调用次数、接口 schema 税);
- 速度(单题耗时、均耗时 ms、最大 ms、看门狗超时数),有时候还会关注点其他指标,包括健康度、可能发现性。
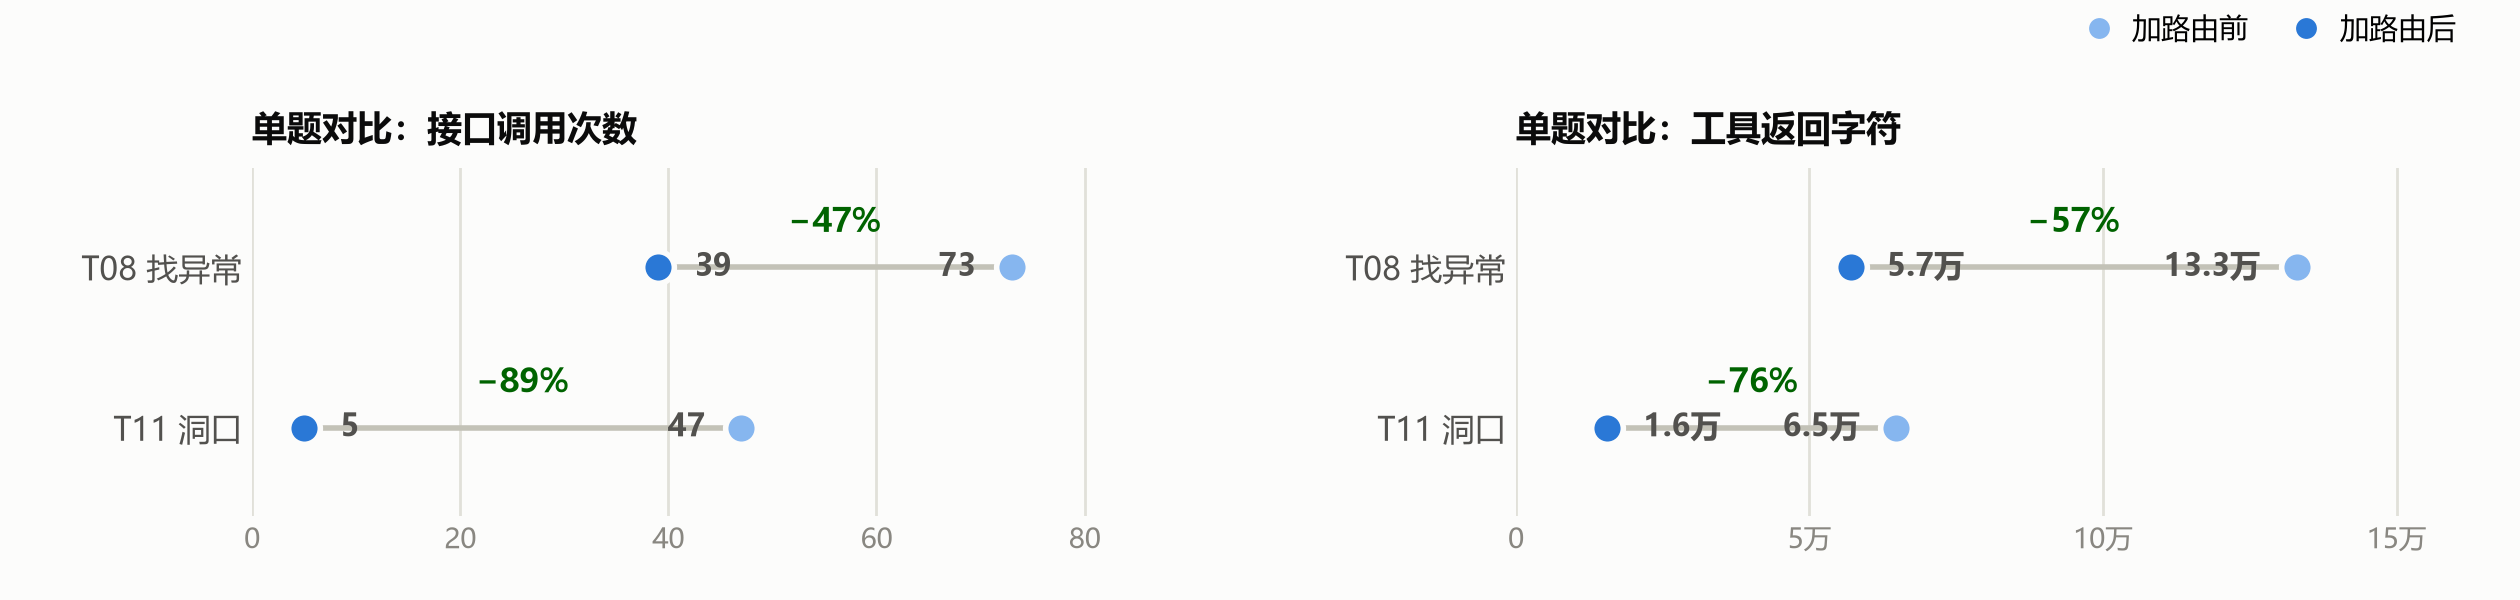
根据我的测试来看,大模型和小模型在某些层面确实有很明显的差距,比如体现在对工具的利用能力上:小模型会经常忘记有哪些工具接口。所以我后面甚至特地做了一个路由层,模型在对场景进行查询之前,可以先调用路由层去确认使用哪个工具会更加合适一点,以调用次数换完成率:
三个硬指标的变化是这样的(取 7 月 21–22 日、10 题同口径的数据):
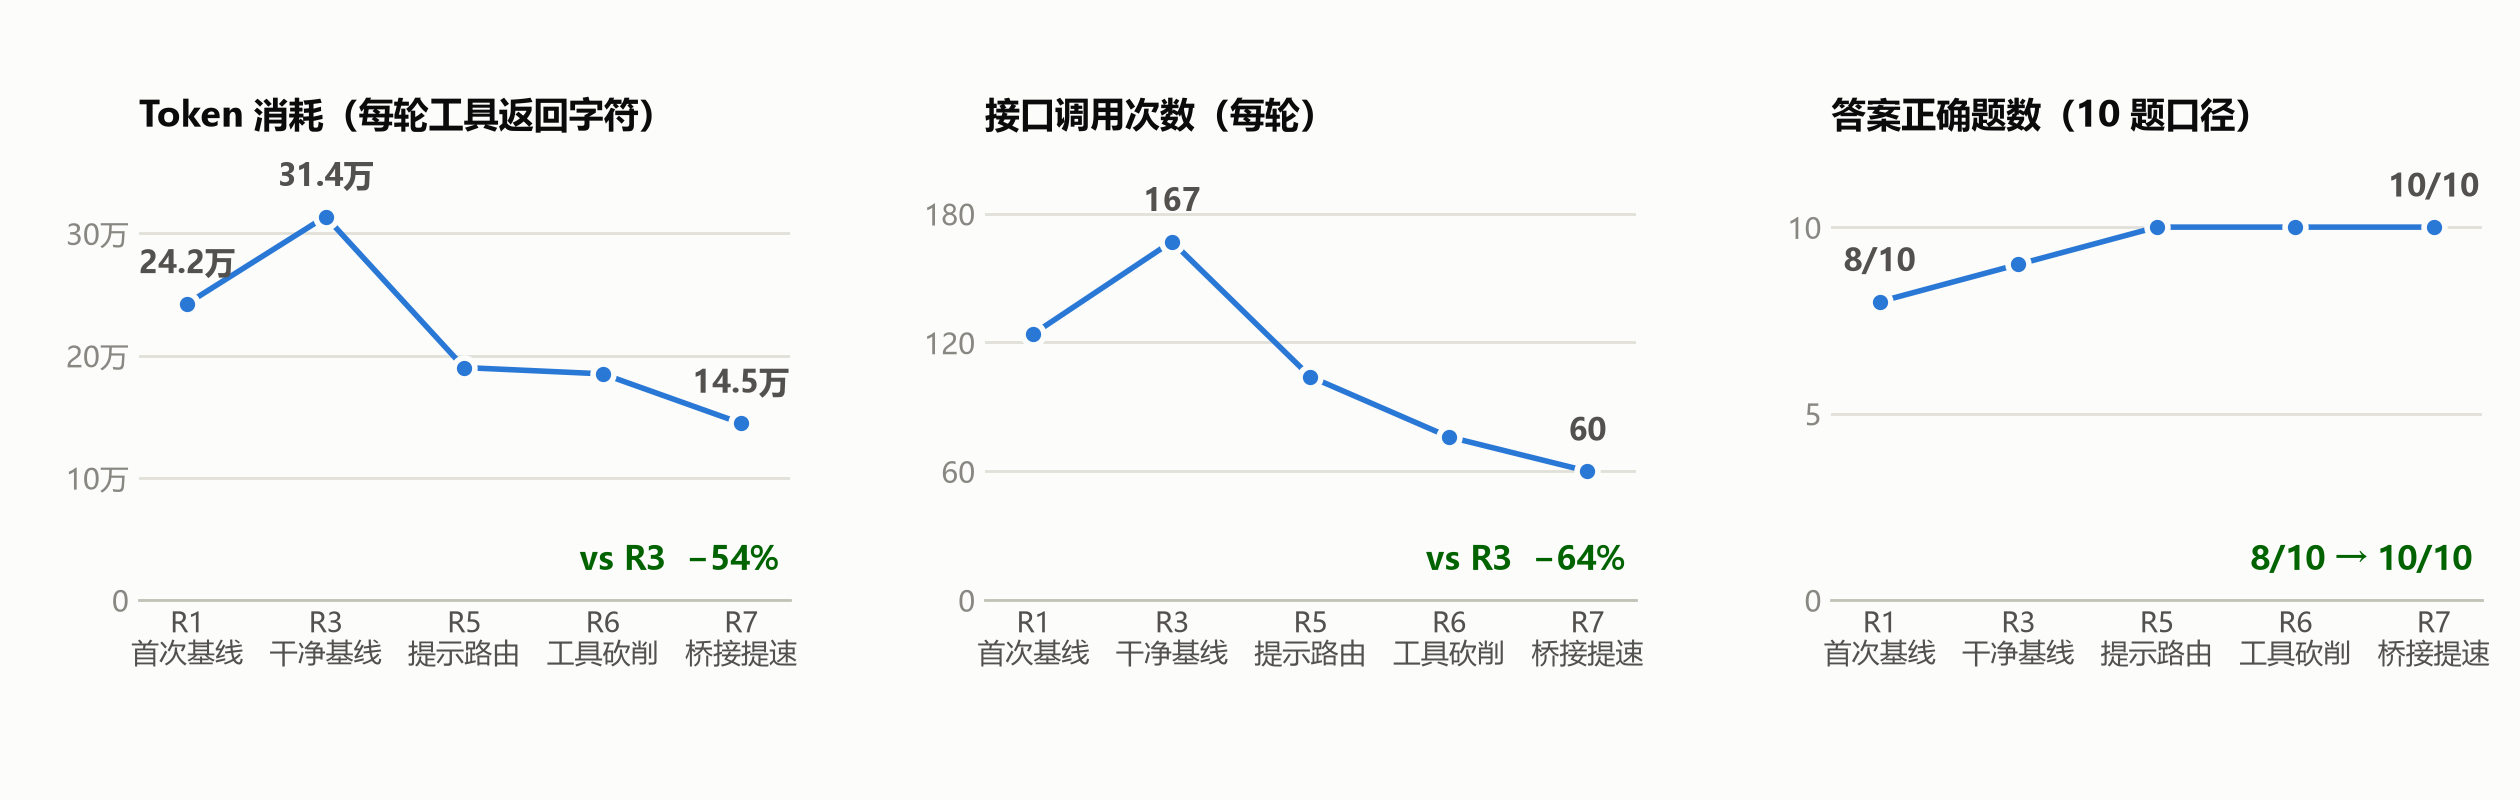
几天下来 Token 降了 54%,调用降了 64%,正确题数升到满分并守住。
之后,又扩展了题库。再经过十多轮迭代后,指标就进入了一个比较平缓的状态。然后再往下就没有太大的意义了,再往下就会出现过拟合的情况。
那这个时候就要加大药量了。
于是我转向了第二阶段的/loop的开发工作:
我构建了被动更新系统:用户每天调用MCP工具时会触发我的Hook、在后台数据库会记录用户调用工具时候的具体问题,以及对话记录,用户也被要求时不时给LLM的任务完成度打分。
这些交流记录会被一个定时的Agent整理成能力需求表(如果发现比较弱的能力的话)。在夜间我下班后,由一个执行的Agent来负责实现这些能力,然后另外一个Agent会调用大量的子agent,对mcp进行测试,最后由这些子agent的主agent总结测试报表与意见。反馈给执行agent。然后执行再进行迭代…以此循环数次,直到新接口的指标稳定下来。
为了做好这个loop循环,我甚至重金购买了两台DGX Spark来本地跑deepseek v4 flash(吃草中…一些不知所谓的军火展示,希望Leader看到这段话给我涨点工资谢谢ლ(╹◡╹ლ)。
其实现在这个/loop我并没有布置到我满意的程度,它还在不停的调优(这里面有太多的事情,包括用户授权、数据脱敏、沙箱、审计、回滚等一大堆问题)。这也是我下一期想聊的内容之一——基于用户真实数据的自进化的Agent系统。
5. GSDL的调用案例
下面给大家看一下GSDL的一个真实调用案例(我在2026 年 7 月 23 日进行的测试):
“这个洞穴有几个可以通行的洞口?它们分别有多宽?”
它很能说明“读取 Actor”和“理解空间”的差别。
如果没有GSDL的话(例如 UE 的 MCP 方案),LLM会直接搜索名字中带 Archway 的资产,把 SM_WallArchway_12x3、SM_WallArchway_3x6 等构件当成洞口。在我的实际测试中,这些叫Archway 的 Actor 实际上是围成洞口的墙,不是洞口本身。这会导致误判。
有GSDL后:
1 | → nm_status ← 确认工具状态 |
同一个问题,加入 find_opening 路由之前,模型用了 47 次工具调用、消耗 64,820 字符,仍然把名字带 Archway 的墙体构件当成洞口;加入路由后,只用了 5 次调用和 15,540 字符,就完成了测量与视觉复核。

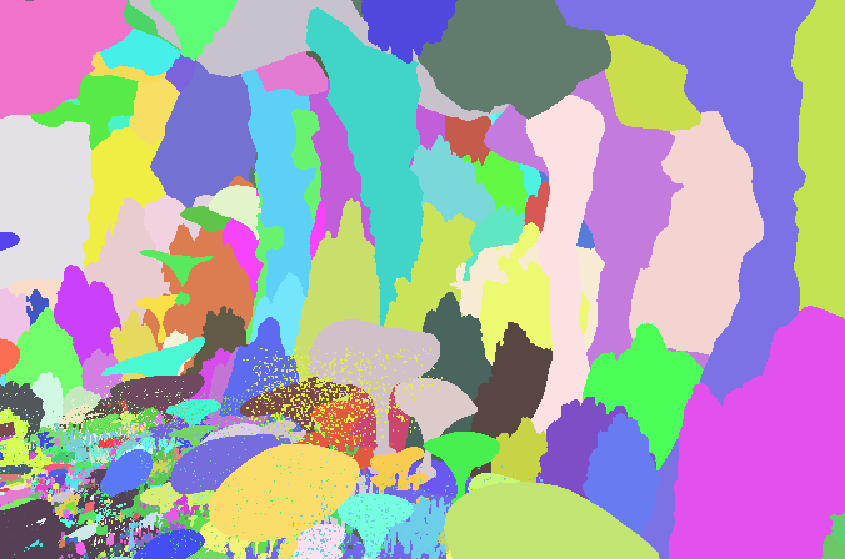
模型随后飞到候选洞口前进行截图复核。掩码中出现了 494 个属于 BP_Sky_Sphere 的像素,说明视线确实能够穿过开口看到外部背景;但这只能作为“开口存在”的视觉旁证。它是否能够通行、宽度是多少,仍由贴近地面的碰撞射线与门框精测结果决定。
最终,系统把候选结构分成了10个地面可通行洞口或通道、高位窗口和天窗,并给出了地面开口的位置与实测宽度。它甚至找出了我此前没有注意到的开口。这里真正重要的不是“搜到了多少个叫 Archway 的 Actor”,而是它能够区分洞壁、内部通道、对外洞口和不可直接通行的高位开口。
6. 项目开源
感谢你看到这里。
这个GSDL项目,我这段时间忙完之后,剥离公司项目内容后,会在Github上开源,欢迎大家一来尝试和提建议。一个人的精力确实太有限了。
项目地址暂时先放在这里了:OpenGSDL 大概9月初会上传。里面会包含着掩码方案 + GSDL。会以 UE 多版本 MCP 插件的形式呈现,你可以基于它做二次开发,或者直接用来辅助UE的官方MCP。
六、Vector Atlas(全地图语义编码)
我之所以做这个东西,是因为每一次模型去查询地图里面的东西,其实都是一个非常久的延迟操作(在这个过程中,要去加载场景,获取掩码、截图…),至少对于我们的项目来说,是一个60s+的操作。更别提,要进行全地图大规模的查询,会显著拉长单次任务的完成时间。所以我在想,能不能让这个过程更加的迅速一点。
并且,我还需要更多关于这个场景的语义信息,这些语义是需要美术来标注的,我一个人是几乎不可能完成整个大地图全部场景的标注,并且场景的语义(比如说,这里是某个NPC的家),会随着项目的推进,一直动态变化,这些也不可能靠我硬编码来实现。所以我需要一个动态地、可编辑的、场景语义收集服务。
所以我做了Vector Atlas(全地图语义编码)这么一个东西。
它结合了我们上面提到的 2D掩码 及 GSDL 两种能力为一身。
把我们全部地图离线编码成一张”可语义检索的视角表”,人可以快速地通过语义检索整张地图里面的内容(可人为添加视角,可人为编辑视角语义),同时也作为 AI 跨会话的长期记忆存储能力(AI添加视角、保留为AI长期记忆,AI 可检索)。
开篇我提到的:把每个位置「背」下来、毫秒级查询的承诺,就靠它兑现。用存储,换性能的工程化实现。
因为这篇文章实在太长了,且Vector Atlas这个东西也是一个非常复杂的项目(要考虑到如何优化搜索、如何拍摄、如何部署、如何让AI得到未拍摄的角度…这些都是要思考的东西)。
所以 Vector Atlas 加上(上面提到的)“基于用户真实数据的自进化的Agent系统”(第二期自进化接口),我会留到下一篇文章详细阐述,那时候,我的系统也更加完善了。在这里仅先简单地预告一下。
下面欣赏一下工具的Demo吧。
七、给碳基生物的版本
八、给硅基生物用的版本以及与Epic方案对比
我准备了 11 道测试题,让每个模型分别只使用 Epic 官方 MCP 或我的 MCP(NeuroMap 08-14版),并保证每道题都是全新上下文,进行三个模型的测试。
| 指标 | DSV4flash + 本地Qwen3.5-9B-4bit Epic |
DSV4flash + 本地Qwen3.5-9B-4bit NeuroMap |
Qwen3.8 27b Epic |
Qwen3.8 27b NeuroMap |
GPT5.6 Luna Epic |
GPT5.6 Luna NeuroMap |
|---|---|---|---|---|---|---|
| Harness | Claude Code | Claude Code | Claude Code | Claude Code | Codex | Codex |
| 完成率 | 100%(11/11) | 100%(11/11) | 72.7%(8/11) | 90.9%(10/11) | 100%(11/11) | 100%(11/11) |
| 正确率 | 77.3% | 77.3% | 59.1% | 86.4% | 90.9% | 90.9% |
| 诚实度 | 95.5% | 90.9% | 68.2% | 72.7% | 86.4% | 90.9% |
| 正式主记录总耗时 | 468分7.0秒 | 64分52.2秒 | 611分8.9秒 | 291分21.8秒 | 141分35.5秒 | 40分3.6秒 |
| 全11题平均耗时 | 42分33.4秒 | 5分53.8秒 | 55分33.5秒 | 26分29.3秒 | 12分52.3秒 | 3分38.5秒 |
| 单题最大耗时 | 197分4.3秒 | 20分15.0秒 | 220分3.8秒 | 84分50.3秒 | 52分1.6秒 | 18分6.3秒 |
| MCP 调用总数 | 514 | 261 | 318 | 221 | 7,919 | 313 |
| 输入 / 输出 | 20,179,996 / 261,572 | 6,158,052 / 119,825 | 10,173,709 / 234,831 | 8,438,133 / 150,085 | 47,692,261 / 207,474 | 21,170,665 / 94,384 |
| 首轮固定开销 | 700 Token | 12,326 Token | 569 Token | 14,761 Token | ~350 Token | ~12,900 Token |
总体上,交付能力整体持平或领先的情况下,NeuroMap 显著减少了调用次数和任务耗时。其中,Luna 这一轮,Epic MCP一共调用了 7,919 次;NeuroMap 只调用 313 次,约为它的 1/25,总耗时也只有 28%。
Epic MCP 提供的是通用、原子化的编辑器操作,模型需要反复路由并逐个查询对象(几乎是在遍历场景actor)。场景一复杂,一道题就可能被拆成成百上千次调用,这些往返会迅速放大。NeuroMap 把区域描述、异常检测、洞口分析等空间计算放在 UE 侧聚合,再用 GSDL 压缩返回,所以三个模型上都表现出更少的调用、更短的长尾和更高的交付率。
正确率上,最值得注意的是 Qwen这一轮测试,我的MCP从 59.1% 大幅提高到 86.4%。这说明聚合式接口不仅更省,也能明显降低较弱模型自己遍历 Actor、判断工具和归纳空间关系的难度。
不过,NeuroMap 当前的 Schema 开销仍然偏高,工具集合也还在持续收敛,后面还得持续优化。
下面是一次实际工作流:只给 AI 一个模糊描述,让它在大场景中寻找“摆着围棋的桌子”,定位目标、调整镜头并保存截图。


九、后记
不知道你有没有发现一个问题,不管是NeuroBrowser(第一期的插件)还是NeuroMap(这一期插件,二者简称NB和NM,我们内部简称他们为您爸插件和您妈插件),其实都在把 AI 能力渗入引擎编辑器,有点“以AI能力再造编辑器”的感觉?
或许下一代游戏编辑器应该长这样呢?您觉得呢?